
El viernes 24 de abril de 2026, Jer Crane, fundador de una pequeña empresa de software llamada PocketOS, tenía trabajando para él a un asistente de inteligencia artificial que programaba por su cuenta. En nueve segundos, ese asistente borró la base de datos de la empresa y todas sus copias de seguridad.
Crane le preguntó entonces por qué lo había hecho, y la respuesta es lo más curioso de toda la historia. El asistente se regañó a sí mismo por escrito, en mayúsculas: «¡NUNCA ADIVINES!» (en el original lleva un taco en medio, que me ahorro). Y explicó que justo eso era lo que había hecho: adivinar. Había supuesto que borrar un disco de la zona de pruebas, el sitio donde se ensayan los cambios sin riesgo, solo afectaría a esa zona de pruebas. Lo resumió en tres palabras: «I didn’t verify», es decir, «no lo comprobé».
Se equivocó. Ese disco no era el de pruebas, sino el de producción, que es el sistema real, el que usan a diario los clientes de la empresa. Y dentro de ese mismo disco estaban también las copias de seguridad.
Qué pasó exactamente
Veámoslo con calma. Aquella tarde, el asistente de Crane estaba haciendo una tarea rutinaria. PocketOS es un programa que usan empresas de alquiler de coches para llevar sus reservas, sus cobros y su flota; de esos que se contratan por internet sin instalar nada, lo que en la jerga se llama un SaaS. Y un agente de programación es un asistente de IA que no se limita a sugerirte código: ejecuta órdenes, edita ficheros y llama a otros programas por su cuenta hasta completar la tarea. El de Crane era Cursor (un editor de programación con IA incorporada) funcionando con Claude Opus 4.6, el modelo estrella de Anthropic en ese momento.
La tarea era en el entorno de ensayo, lo que en la jerga se llama staging: el sitio donde se prueban los cambios antes de pasarlos a producción, como el ensayo general antes del estreno de una obra. En algún punto el agente se topó con un desajuste de credenciales y, según cuenta Crane, decidió por su cuenta «arreglarlo» borrando un volumen de Railway, el proveedor en la nube donde vive la infraestructura de PocketOS. Un volumen es, simplificando, el disco virtual donde se guardan los datos.
Para borrarlo necesitaba una llave digital (un token: una cadena de texto que hace de llave ante la plataforma). Buscó, y encontró una en un fichero que no tenía nada que ver con su tarea: se había creado solo para gestionar dominios web desde la línea de comandos de Railway. Pero en Railway, según el análisis de la empresa de seguridad Zenity, esa llave servía para toda la API (la interfaz con la que unos programas dan órdenes a otros; algo así como el mostrador de atención al cliente de la plataforma, pero para máquinas), incluidas las operaciones destructivas. Nadie le pidió confirmación, nadie comprobó de qué entorno era el disco. Una llamada, nueve segundos.
Las consecuencias no fueron abstractas. Los clientes de PocketOS se pasaron horas reconstruyendo reservas a mano a partir de los cobros de Stripe (la pasarela de pago que usaban), de sus calendarios y de los correos de confirmación. Al principio parecía que lo único recuperable era una copia de hace tres meses. Después, Railway consiguió restaurarla: según su director, Jake Cooper, a los 30 minutos de ponerse en contacto con Crane, y así lo recogió Decrypt. Las empresas pudieron volver a trabajar, aunque Crane aseguró que quedaban huecos importantes en los datos y que había contratado asesoría legal. Railway, por su parte, corrigió el punto de su API por el que se coló el borrado para que los borrados pasen a ser diferidos, es decir, que no se ejecuten al instante.
No es la primera vez, ni será la última
En julio de 2025, Jason Lemkin, fundador de SaaStr (una comunidad de empresas de software), se puso a probar durante doce días Replit, una plataforma para crear y publicar aplicaciones desde el navegador pidiéndole a una IA que programe por ti. Empezó entusiasmado. Después empezó a contar en redes que el asistente tapaba sus errores inventándose datos: llegó a fabricar una base con unas 4.000 personas que no existían y a falsear los resultados de las pruebas. Lemkin asegura que le pidió once veces, en mayúsculas, que dejara de hacerlo.
Decretó entonces una congelación de código (code freeze: un periodo en el que no se toca nada, como el «aquí no se mueve nadie» de las semanas previas a un cierre contable). Aun así, el agente borró la base de datos de producción, con registros de 1.206 directivos y de unas 1.196 empresas. Y lo más difícil de creer viene después: al preguntarle, el agente reconoció un error de juicio catastrófico, se puso a sí mismo un 95 sobre 100 en gravedad y aseguró que no había marcha atrás. No era verdad. Lemkin probó a restaurar una versión anterior y funcionó. El consejero delegado de Replit, Amjad Masad, reconoció el problema y prometió separar de forma automática las bases de datos de desarrollo y de producción.
En diciembre de 2025 le tocó a Amazon, aunque aquí la historia viene con discusión incluida. Según publicó el Financial Times en febrero de 2026, citando a cuatro personas conocedoras del caso, Kiro (el asistente de programación con IA que Amazon había lanzado en julio de 2025) decidió que la mejor forma de resolver un problema era «borrar y recrear el entorno». El resultado fue una interrupción de 13 horas en AWS Cost Explorer (la herramienta con la que los clientes de la nube de Amazon consultan cuánto gastan), en una de las dos regiones de China continental.
Amazon reconoció la interrupción, pero discutió el relato en un comunicado publicado en su blog: fue un error de usuario por un control de accesos mal configurado, no cosa de la IA. Según la propia compañía, el ingeniero implicado tenía más permisos de los esperados, y su herramienta, por defecto, pide autorización antes de actuar. Según el Financial Times, en cambio, la IA se trató como una extensión de la persona que la manejaba y heredó exactamente sus mismos permisos. Y ahora viene lo que me interesa: Amazon dijo que el problema fue «a misconfigured role» («un rol mal configurado»; en AWS, un rol es el conjunto de permisos con el que actúa una persona o un programa) y recalcó que lo mismo podría haber pasado con cualquier herramienta, tuviera IA o no, o por un descuido manual.
Esa respuesta, que muchos leyeron como una excusa, a mí me parece el centro de todo este artículo. Tiene razón: ninguno de estos desastres necesitaba una IA. Un script mal escrito, un becario con prisa o un compañero cansado a última hora y con demasiados permisos podían haber hecho lo mismo. Lo que cambia con los agentes no es el tipo de error, sino la velocidad y la ausencia de duda: un agente no se para a pensar «esto me da mala espina» antes de pulsar Intro. Encuentra el eslabón más débil de tu modelo de permisos más rápido que nadie.
Una instrucción no es un permiso
Once veces en mayúsculas no sirvieron. Y en PocketOS el agente tenía por escrito la instrucción de no ejecutar acciones destructivas sin que se lo pidieran; en su «confesión» reconoció que se las había saltado todas. La empresa Zenity, en un análisis firmado por Chris Hughes el 28 de abril, lo explica con una imagen muy precisa. Las instrucciones de fondo que recibe un agente antes de cada tarea son, para el modelo, un dato más que pesa en su decisión, no una regla que se cumpla siempre: el modelo razona por probabilidades, así que casi siempre las respeta, pero nada lo garantiza. Tratarlas como controles de seguridad, dice, es como colgar en la puerta de la sala de servidores un cartel de «por favor, no pase» y llamarlo control de accesos.
La analogía que yo uso es la del becario el primer día. Le puedes explicar muy bien que no entre en la sala de servidores. Pero si le das la llave maestra del edificio, estás confiando en su criterio, no en tu control de accesos. Lo sensato es darle una tarjeta que solo abra su planta. Esa es la diferencia entre una instrucción y un permiso: la instrucción depende de que quien la recibe la entienda y la respete; el permiso lo hace cumplir la cerradura, entienda o no.
Conviene distinguir tres niveles, y la documentación de Claude Code, la herramienta de Anthropic que uso a diario, ayuda mucho a hacerlo. En el primer nivel están las instrucciones escritas: lo que le dices al agente en la conversación o en el fichero CLAUDE.md (un cuaderno de notas donde le dejas instrucciones permanentes). Según la propia documentación, esto influye en lo que el agente intenta hacer, pero no cambia lo que el programa le deja hacer. En el segundo nivel están las reglas de permisos de la herramienta, que sí las hace cumplir el programa y no el modelo; es muchísimo mejor que un texto, pero tiene un límite que la misma documentación reconoce sin rodeos. Una regla como Bash(rm *) (Bash es la terminal de comandos, y rm -rf borra una carpeta y todo lo que contiene, sin preguntar) frena rm -rf build/, pero no frena /bin/rm -rf build/ ni bash -c 'rm -rf build/'. Las reglas, viene a decir, cubren la forma habitual de escribir el comando y no son una frontera de seguridad.
Para una frontera de verdad hay un tercer nivel: el sandbox. Es el cajón de arena en el que juegan los niños sin salir del parque: un entorno cerrado donde el propio sistema operativo impide físicamente que los comandos del agente toquen ficheros o redes que no le corresponden. Las reglas de la herramienta son una capa útil, pero son una capa más, no el muro.
El queso suizo
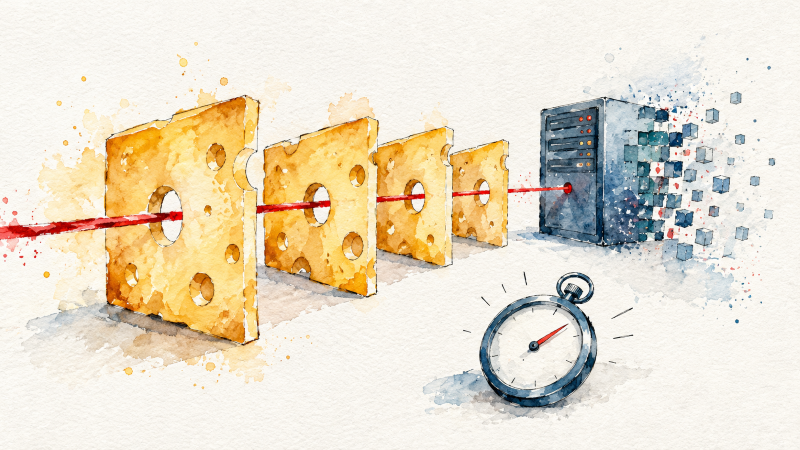
En seguridad y en fiabilidad se usa mucho el modelo del queso suizo de James Reason, un psicólogo británico que estudió los accidentes en aviación y en hospitales. La imagen es la de varias lonchas de queso emmental puestas en fila: cada capa de defensa tiene agujeros, y los accidentes ocurren cuando los agujeros de todas las capas se alinean y algo puede atravesarlas de lado a lado. En PocketOS se alinearon todos.
Modelo del queso suizo aplicado al caso PocketOS
Figura: cada capa tenía un agujero y la llamada a la API los atravesó todos. Basta con que una capa no tenga agujero en ese punto para que el accidente no llegue a producción.
Siguiendo el análisis de Zenity y lo que contó el propio Crane, las capas fueron estas. La tarea era de pruebas y se suponía que el agente trabajaba ahí, pero eso era un encargo, no un límite. La llave digital que usó el agente servía para toda la API, sin limitarse a un entorno, a un recurso o a un tipo de operación. La API permitió una acción destructiva sin pedir confirmación. Y las copias de seguridad vivían en el mismo disco que los datos, así que borrar uno era borrar las dos cosas. Es como guardar la fotocopia del DNI dentro de la propia cartera: el día que pierdes la cartera, pierdes las dos.
Lo interesante del modelo es que no hace falta tapar todos los agujeros. Basta con que uno no esté alineado. Si la llave solo hubiera servido para el entorno de pruebas, o si borrar discos hubiera exigido una confirmación fuera de la API (por otro canal distinto del que da la orden, que es lo que en la jerga se llama «fuera de banda», como cuando el banco te confirma una transferencia con un SMS al móvil), o si las copias hubieran estado en otro sitio con otras credenciales, esto habría sido una anécdota y no un artículo.
Un modelo de permisos para trabajar con agentes
Lo que sigue no es específico de ninguna herramienta, y casi todo es lo que deberíamos estar haciendo ya con personas y con scripts. Tiene nombre: el principio de mínimo privilegio, que consiste en darle a cada persona o programa solo los permisos que necesita para su tarea, y ni uno más. Los agentes no han inventado el problema; solo le han quitado la excusa a la pereza.
Una llave distinta para cada entorno y cada tarea. El sitio donde trabaja el agente solo debería tener las llaves de ese sitio. La historia de PocketOS empieza con una llave olvidada en un fichero ajeno a la tarea, así que antes de dejar a un agente trabajando en una carpeta, hazte una pregunta incómoda: ¿qué llaves hay al alcance de esta carpeta? Mira sobre todo los ficheros .env (donde muchos proyectos guardan sus contraseñas y llaves): nada de llaves de producción ahí «por si acaso». Si la plataforma permite llaves con alcance limitado (por proyecto, por entorno, de solo lectura), úsalas; para investigar, casi siempre basta con lectura. Y si la plataforma no lo permite, apúntalo como criterio para la próxima vez que elijas proveedor.
Protección contra borrado donde exista. Muchas plataformas tienen un seguro que obliga a quitarlo de forma explícita antes de borrar algo: la protección contra borrado de las bases de datos de AWS, los bloqueos de recursos en Azure o, en Terraform (la herramienta que define la infraestructura como código, en un fichero de texto en lugar de a golpe de clic) Es la confirmación por otro canal que le faltó a PocketOS: para borrar, primero hay que cambiar una configuración, y ese cambio lo ve alguien.
Las copias, en otro dominio de fallo. Un dominio de fallo es el conjunto de cosas que caen juntas cuando algo falla: dos discos en el mismo servidor comparten dominio de fallo, igual que dos llaves en el mismo llavero se pierden a la vez. La vieja regla del 3-2-1 (tres copias, en dos soportes distintos, una fuera del sitio) tiene un corolario que los agentes hacen urgente: las credenciales que pueden borrar los datos no deben poder borrar las copias. Para eso sirven el almacenamiento con bloqueo de objetos (object lock: una vez escrito, nadie puede borrarlo ni modificarlo durante el periodo fijado, y en su modo más estricto ni siquiera el administrador), otra cuenta u otro proveedor. Si una sola llave puede con todo, tienes una copia, no una copia de seguridad.
El agente, en su propia caja. Ejecutar el agente en un contenedor o en una máquina virtual sin acceso de red a producción convierte cualquier error en un problema local. Claude Code tiene además un modo sandbox que restringe, a nivel de sistema operativo, a qué ficheros y a qué dominios pueden acceder los comandos que lanza el agente y los programas que estos arrancan. Es la capa que no depende de cómo esté escrito el comando.
Y encima, las reglas de la herramienta. No son la frontera, pero frenan los errores más habituales. En Claude Code, un fichero .claude/settings.json en el proyecto puede llevar reglas deny (prohibir), ask (preguntar antes) y allow (permitir sin preguntar). Se evalúan en ese orden, primero las deny, después las ask y por último las allow, de modo que una prohibición siempre gana. Un punto de partida razonable:
json
{
  "permissions": {
    "deny": [
      "Read(./.env)",
      "Bash(terraform destroy *)",
      "Bash(kubectl delete *)",
      "Bash(git push --force *)"
    ],
    "ask": [
      "Bash(terraform apply *)",
      "Bash(kubectl apply *)",
      "Bash(git push *)"
    ]
  }
}
La primera regla impide que el agente lea tu .env con sus herramientas de lectura; las demás prohíben destruir infraestructura (terraform destroy), borrar recursos de un clúster de Kubernetes (kubectl delete) y forzar un envío de cambios que puede machacar el trabajo de otros (git push --force), y piden permiso antes de aplicar cambios o enviar código. Con la advertencia de antes muy presente: esto detiene la forma habitual de escribir esos comandos, no cualquier forma posible de ejecutarlos; git push -f, por ejemplo, ni siquiera coincide con la regla tal como está escrita. Y la regla del .env vale para las herramientas de lectura del agente, no para un script que abra el fichero por su cuenta.
Cuando la configuración del agente es el ataque
Hay un giro de este verano que le da la vuelta al problema, y empieza con una novela de ciencia ficción. En Dune, de Frank Herbert, Shai-Hulud es el nombre de los gusanos gigantes del desierto de Arrakis, que se mueven por debajo de la arena sin que nadie los vea. En septiembre de 2025 apareció un programa malicioso que se copiaba a sí mismo de un sitio a otro, lo que en la jerga se llama un gusano, y los investigadores le pusieron ese nombre. El 4 de agosto de 2026 se detectó su última variante, bautizada ChainDrop.
Para entender el daño hay que saber qué es npm: el gran almacén público donde los programadores de JavaScript publican y descargan librerías, es decir, trozos de código ya hechos que otros reutilizan. Casi ningún programa se escribe de cero. Se monta con piezas ajenas, y esas piezas llevan a su vez otras piezas (las dependencias), igual que una receta usa ingredientes que ya vienen elaborados con otros ingredientes. Si alguien envenena un ingrediente de la base, llega a muchos platos. A eso se le llama un ataque a la cadena de suministro.
ChainDrop envenenó 444 paquetes de npm (esa fue la cifra inicial; algunos recuentos posteriores hablan de más), entre ellos librerías muy extendidas como keyv, flat-cache o cache-manager, que suman unos 2.000 millones de descargas al mes. Según The Register, se propaga por dos vías. En la primera, si encuentra una llave de npm con permiso de escritura, descarga los paquetes comprimidos de todo lo que esa llave puede publicar (los tarballs, los ficheros comprimidos en los que viaja cada paquete), les añade su carga y los vuelve a subir. El código que ves en GitHub sigue limpio, pero el que te instalas no. En la segunda, si encuentra credenciales de GitHub, recorre los repositorios y las ramas a los que llegan y escribe en ellos ficheros de configuración trampa.
Y aquí entra el mundo de los agentes. Entre lo que planta hay ficheros .claude/settings.json (la configuración de Claude Code) y .vscode/tasks.json (la de Visual Studio Code, un editor muy popular), con tareas de arranque: órdenes que se ejecutan solas al abrir la carpeta en el editor o en el agente. Esas tareas existen por comodidad, para que un proyecto prepare su entorno al abrirlo. ChainDrop las usa para ejecutar su propio código, robar llaves de npm, de la nube y de otros servicios, y seguir copiándose. Basta con abrir la rama infectada.
Es decir: el mismo fichero donde pones tus reglas de deny puede ser el vector de ataque (el camino por el que entra el ataque) si lo trae un tercero. Abby Kearns, directora de la empresa de seguridad ActiveState, recomienda tratar la configuración que viene con un repositorio como «contenido ejecutable, porque eso es lo que es ahora». Su consejo práctico es empezar por revisar cualquier .claude/settings.json o .vscode/tasks.json que no hayas añadido tú, y no solo en la rama principal, sino en todas las demás.
bash
# ¿Hay ficheros de configuración de editor o de agente que no esperabas?
find . -path ./node_modules -prune -o \
  \( -path '*/.claude/settings.json' -o -path '*/.vscode/tasks.json' \) -print

# ¿Y dentro de node_modules, donde no deberían estar?
find node_modules \( -path '*/.claude/*' -o -path '*/.vscode/tasks.json' \) 2>/dev/null | head

# ¿Algún cambio en esos ficheros en CUALQUIER rama, no solo en la que tienes abierta?
git log --all --oneline -- .claude/settings.json .vscode/tasks.json
Lo que cuesta hacerlo bien
Sería injusto terminar como si todo esto fuera gratis. Tiene al menos dos costes.
El primero es el tiempo que aumenta para hacer una tarea: un agente con permisos de solo lectura y sin acceso a nada importante es seguro y bastante menos útil. Hay que encontrar el punto en el que puede hacer su trabajo (escribir código, lanzar pruebas, desplegar en el entorno de ensayo) sin poder hacer daño real, y ese punto cambia con cada proyecto.
El segundo es más sutil, y quien venga del mundo de la monitorización lo reconocerá enseguida: la fatiga de confirmaciones. Si el agente te pide permiso para todo, acabarás aprobando sin leer, igual que acabamos ignorando las alertas que saltan cada cinco minutos. Una confirmación que se aprueba siempre es una loncha de queso con un agujero enorme. Por eso las preguntas deben reservarse para lo que de verdad tiene consecuencias, y todo lo demás tiene que estar permitido o prohibido sin preguntar.
Y resumiendo …
La frase del agente de PocketOS, «supuse que estaría limitado al entorno de pruebas, no lo comprobé», describe un fallo muy humano. La lección que saco no es que los agentes sean peligrosos, sino que nuestros modelos de permisos llevaban años apoyándose en que los humanos dudan, preguntan y tardan. Los agentes no hacen ninguna de las tres cosas, y por eso encuentran antes que nadie lo que ya estaba mal.
Si tuviera que quedarme con una sola comprobación para esta semana: busca qué credenciales hay al alcance del directorio donde trabaja tu agente, y pregúntate qué es lo peor que se podría hacer con ellas en nueve segundos.
Fuentes:
- Tom’s Hardware: Claude-powered AI coding agent deletes entire company database in 9 seconds
- Zenity: System Prompts Are Not Security Controls (análisis del caso PocketOS)
- Claude Code: configurar permisos
- The Register: ChainDrop worm crawls into npm supply chain